Sentinet³ Core
Una sola piattaforma per sapere cosa funziona, che cosa sta cambiando e dove intervenire.
Dal controllo del singolo host alla visione d’insieme
Sentinet³ Core è il nucleo operativo della piattaforma Sentinet³. Controlla in modo continuo disponibilità e prestazioni di sistemi, dispositivi di rete, servizi software e infrastrutture tecnologiche, trasformando una moltitudine di verifiche puntuali in un quadro coerente e navigabile.
Un host attivo non garantisce che i servizi siano utilizzabili. Il Core associa ai nodi monitorati controlli specializzati, ciascuno con frequenza, parametri, soglie, stato e storico, e applica lo stesso modello alle strutture fisiche (un data center, una sede remota, un UPS) e a quelle logiche, come servizi e componenti software.
Principi operativi
- Monitoraggio unificato da una console web, con navigazione fino al singolo host o servizio.
- Rilevamento anticipato delle condizioni critiche attraverso controlli e soglie configurabili.
- Infrastrutture eterogenee supportate tramite protocolli standard, agent, script e plug-in.
- Rappresentazione visiva degli stati con mappe, grafici e indicatori di disponibilità.
- Ricostruzione temporale degli eventi, interventi automatici e procedure di escalation.
Il risultato è un tempo più breve per individuare e diagnosticare un problema, e il passaggio da una gestione solo reattiva a una sorveglianza continua e misurabile. Come funziona
Controlla, Avvisa, Agisce, Analizza
Il Core lavora in un ciclo continuo: verifica lo stato di ogni componente, avvisa chi deve intervenire, esegue le azioni correttive previste e analizza eventi e storico.
Controlla
Controlli continui con frequenza, soglie, stato e storico su host, apparati, applicazioni e sensori.
Avvisa
Notifiche via email, SMS e voce, gruppi di reperibilità, escalation e antiflooding.
Agisce
Comandi e sequenze preconfigurate al verificarsi di determinate condizioni.
Analizza
Correlazione degli eventi e Root Cause Analysis, Time Machine, Situation Analysis e report SLA.
IT monitoring
Sistemi, rete e applicazioni nella stessa console e nello stesso modello di stato.
Datacenter monitoring
Monitoraggio ambientale del data center orientato alla Disaster Prevention.
OT monitoring
Monitoraggio di impianti e sistemi industriali, compatibile con Modbus, Fieldbus, OPC e SCADA.
Cosa controlla il Core
Sistemi, rete, applicazioni e ambiente fisico del data center nello stesso modello di stato, con soglie, storico e notifiche.
Infrastruttura e sistemi
Windows, Linux e Unix: CPU, memoria, dischi, processi e servizi. Hardware, RAID, SMART e storage; VMware ESX, Hyper-V, Xen e KVM; Active Directory, DNS, DHCP, SMTP, RADIUS e NTP.
ApprofondisciRete
Router, switch e firewall: raggiungibilità, porte, utilizzo delle interfacce, banda, latenza ed errori. Interface Inspector, SNMP polling e trap, porte TCP e UDP, collegamenti tra sedi.
ApprofondisciApplicazioni e servizi
Tomcat, WebSphere, WebLogic e JBoss; Exchange, SharePoint e IIS; Oracle, SQL Server, MySQL, DB2 e PostgreSQL. Verifiche HTTP e transazioni web collegate alle risorse di sistema.
ApprofondisciAmbiente e data center
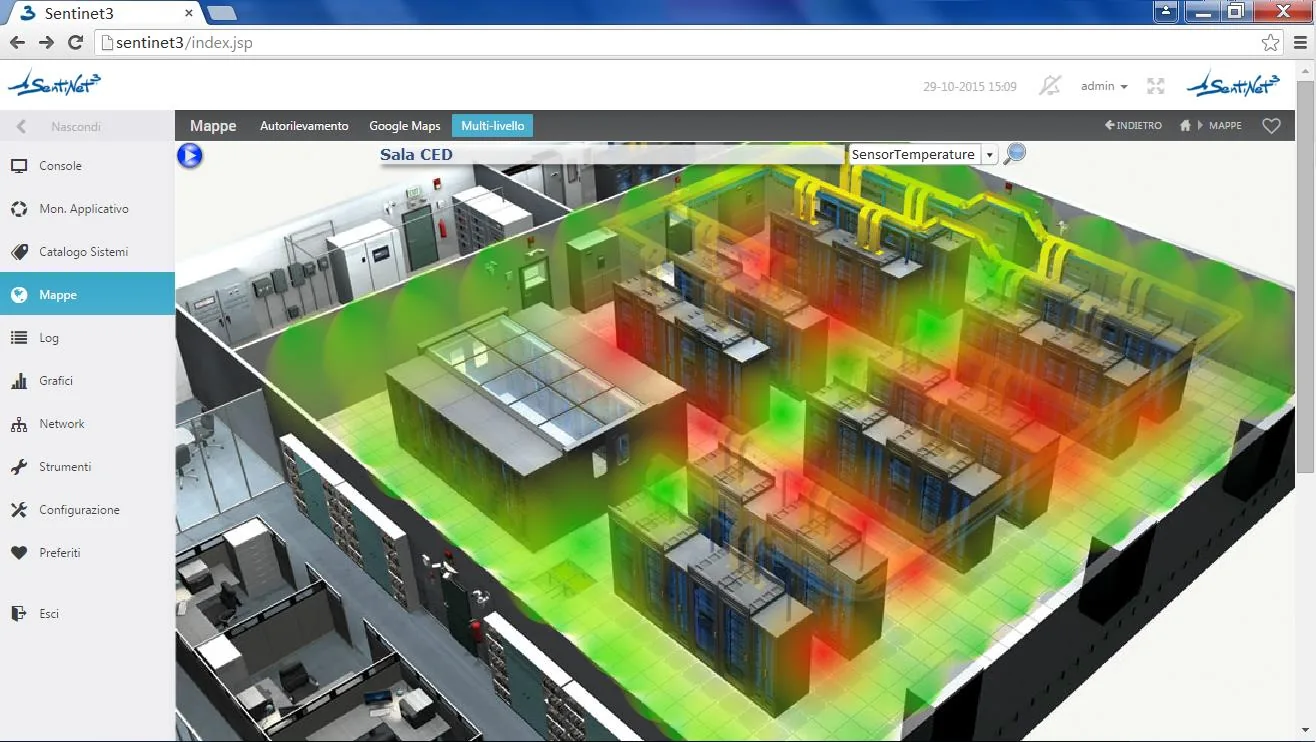
Sensor Probe nei locali tecnici e nei corridoi dei rack: temperatura e umidità, alimentazione e UPS, fumo e allagamenti, contatti porta e videosorveglianza, con azioni correttive integrate.
ApprofondisciConsole e mappe
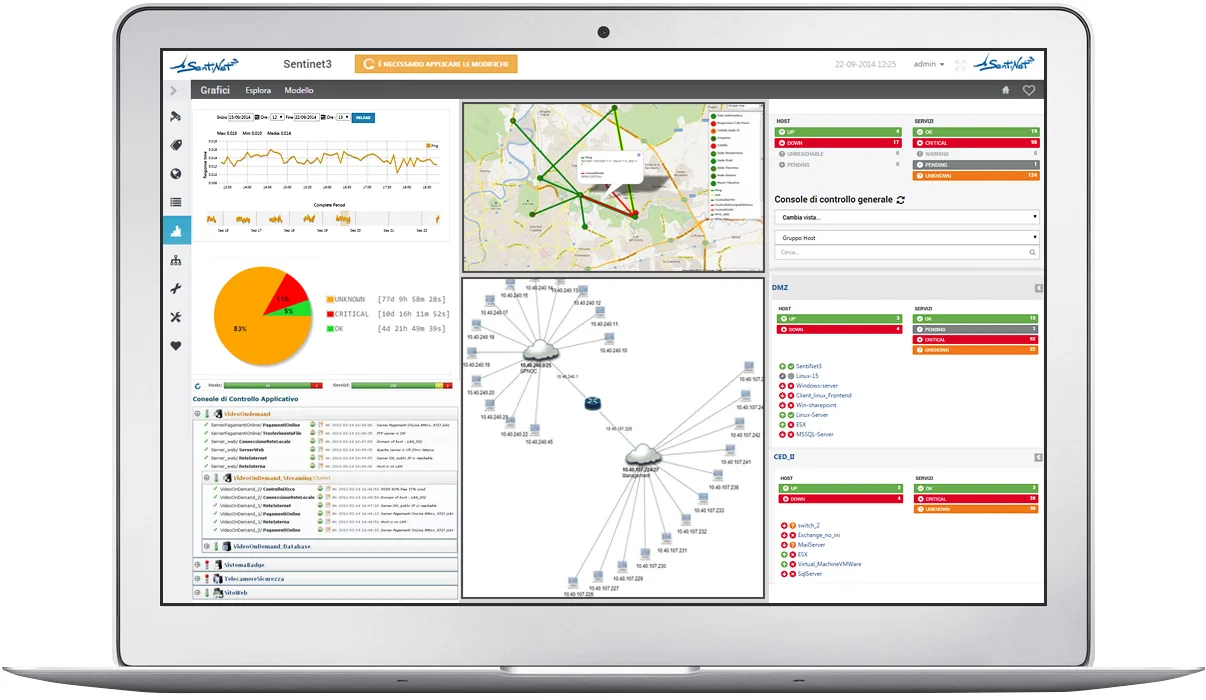
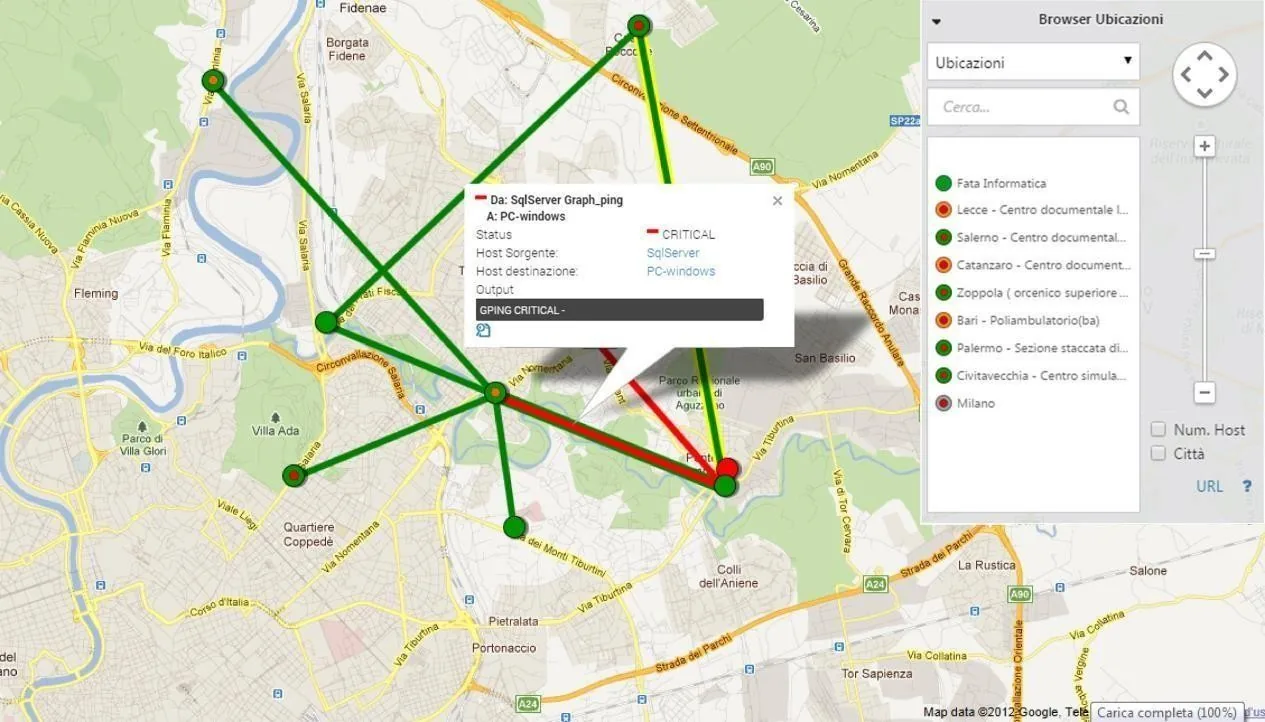
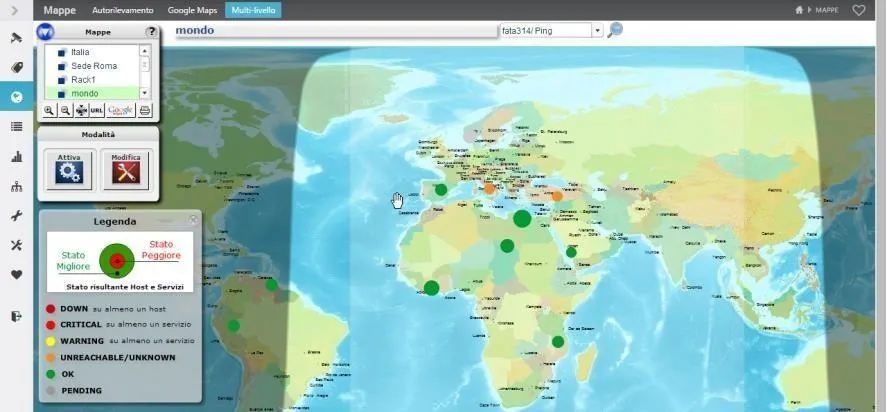
Lo stato dei sistemi in primo piano, dalle viste sintetiche alle mappe di dettaglio: dalla dislocazione geografica delle sedi, con successivi drill-down, fino al data center, al rack e al singolo componente.
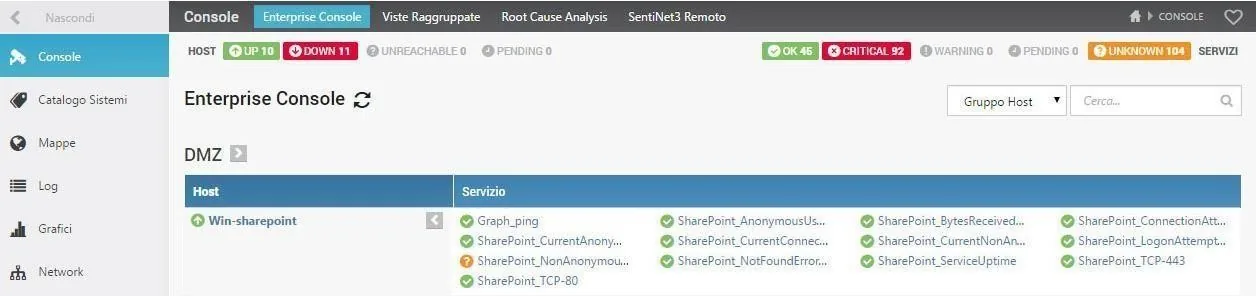
- Enterprise Console con stati di host e servizi, categorie operative, filtri e raggruppamenti.
- Tactical Overview: una pagina personalizzata con i controlli e i report prioritari.
- Mappe multilivello e georeferenziate con indicatori visivi dello stato degli host.
- Servizi tratta che sintetizzano lo stato del collegamento fra due punti della mappa.
- Interfaccia web responsive, consultabile da desktop, smartphone e tablet.
Funzionalità chiave
Enterprise Console
- Stati di host e servizi in forma sintetica.
- Categorie operative distinte, filtri e raggruppamenti.
- Navigazione fino al singolo host o servizio.
Tactical Overview
- Pagina costruita dall’operatore.
- Controlli e report ritenuti prioritari.
- I sistemi più rilevanti sempre sotto osservazione.
Mappe multilivello e georeferenziate
- Dalla dislocazione geografica delle sedi al data center e ai rack.
- Stato degli host rappresentato con indicatori visivi.
- Collegamenti geografici espressi con servizi tratta.
Accesso da desktop e mobile
- Console, stati e informazioni di monitoraggio da smartphone e tablet.
- Il personale reperibile verifica l’allarme e il suo contesto fuori dalla sala operativa.
- Accessi governati da ruoli e credenziali dell’installazione.
Time Machine
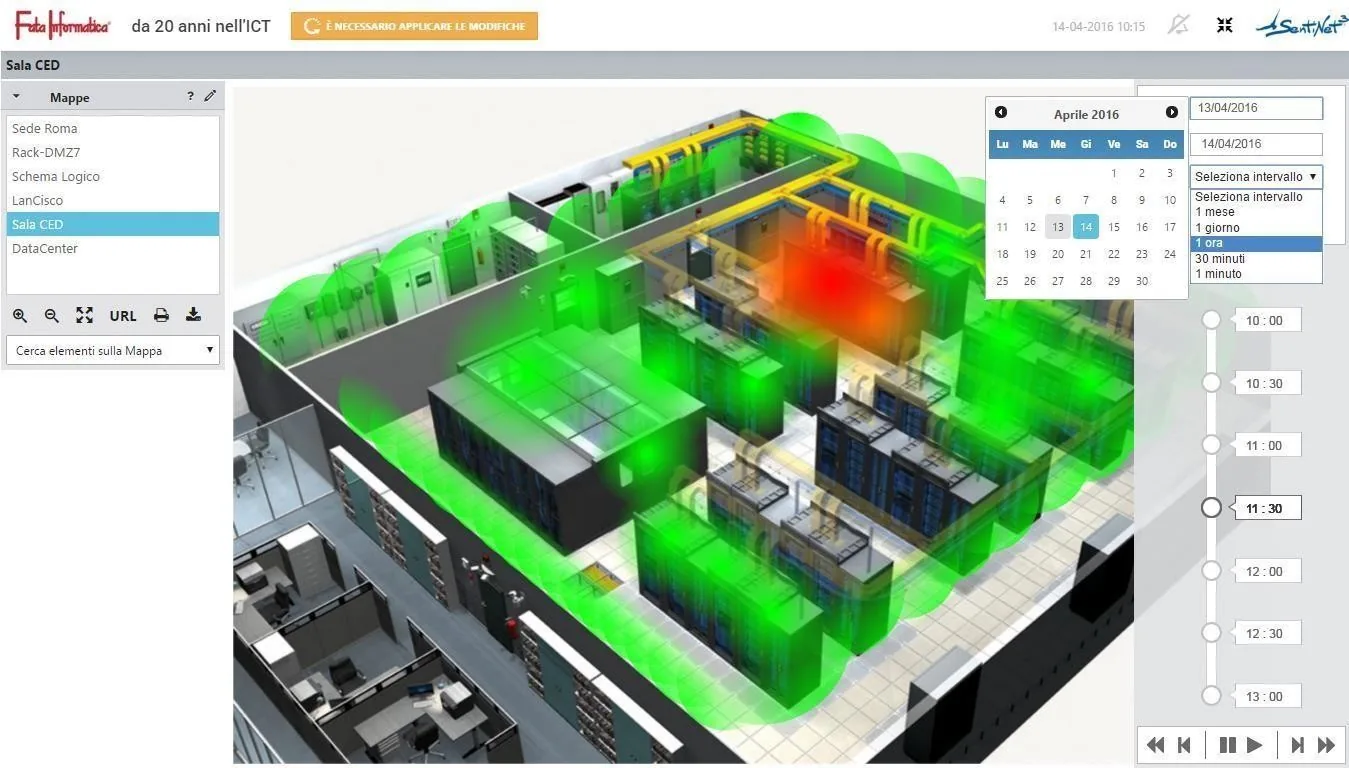
Tornare a un momento passato per comprendere il guasto nel contesto in cui si è verificato. La Time Machine riporta console e mappe alla data e all’ora di interesse, ricostruendo in modo sincronizzato gli stati di sistemi e servizi osservati in quel momento.
- Si parte dall’istante del disservizio indicato dalla notifica o dal log.
- Si osservano insieme host e servizi che risultavano critici.
- Si seguono mappe e relazioni per individuare l’area di maggiore impatto.
- Si confrontano gli stati prima e dopo l’anomalia per ricostruirne evoluzione e ripristino.
- Ideale quando l’incidente è avvenuto in un intervallo senza presidio.
Funzionalità chiave
Ricostruzione sincronizzata
- Console e mappe riportate alla data e all’ora di interesse.
- Stati di sistemi e servizi ricostruiti nello stesso istante.
Troubleshooting orientato
- Una vista contestuale del passato al posto di numerosi log consultati separatamente.
- Non sostituisce l’analisi dei log, ma la orienta verso componenti e intervalli rilevanti.
Stato puntuale e tendenze
- Time Machine mostra com’era l’infrastruttura in un momento specifico.
- Situation Analysis misura tendenze e distribuzioni su periodi selezionati.
Trasversale ai moduli Infinity
- Storico dello stato degli asset, delle informazioni degli agent e degli allarmi contestualizzati.
- Security Insight ne usa le viste temporali per confrontare lo stato di sicurezza degli host.
Behavioural Learning Engine e correlazione degli eventi (Root Cause Analysis)
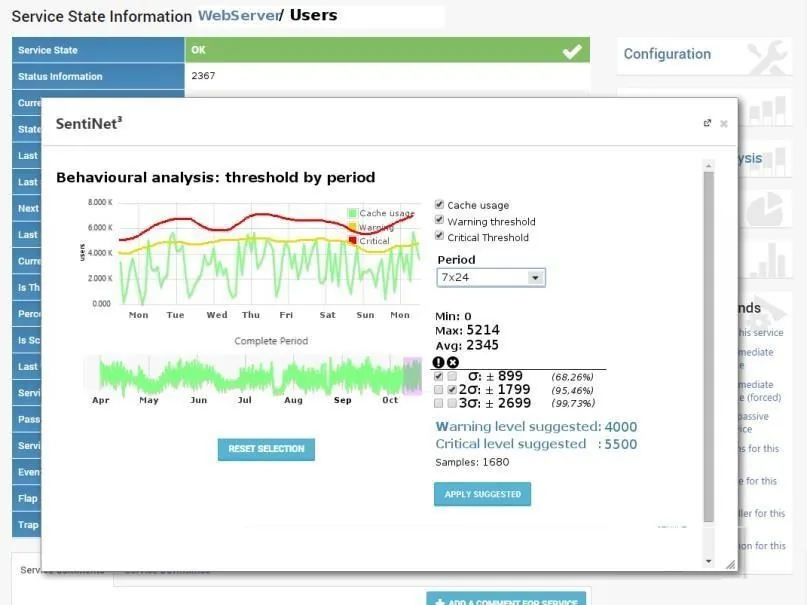
Leggere l’andamento delle metriche, proporre soglie più aderenti e risalire alla causa di un disservizio: due funzioni complementari per configurare controlli più utili e concentrare il troubleshooting sui sistemi responsabili.
- Behavioural Learning Engine: Behavioral Thresholding, Dependency Model detection e Trend Prediction.
- Condizioni ricorrenti distinte dalle anomalie e configurazioni non più aderenti messe in evidenza.
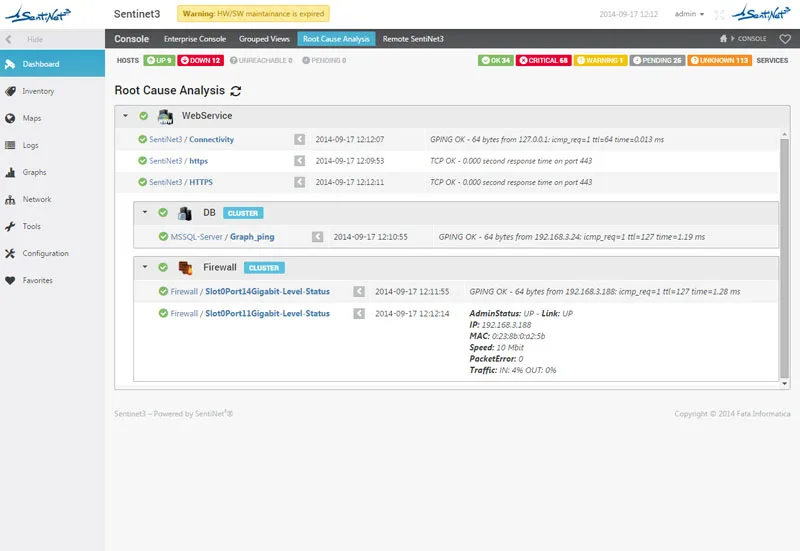
- Correlazione degli eventi con regole basate sugli operatori AND e OR: più eventi correlati generano alert ed eventi proattivi.
- La correlazione individua la causa alla radice, consultabile nella console di Root Cause Analysis.
- Vista gerarchica per separare i sintomi dall’origine del disservizio.
Situation Analysis
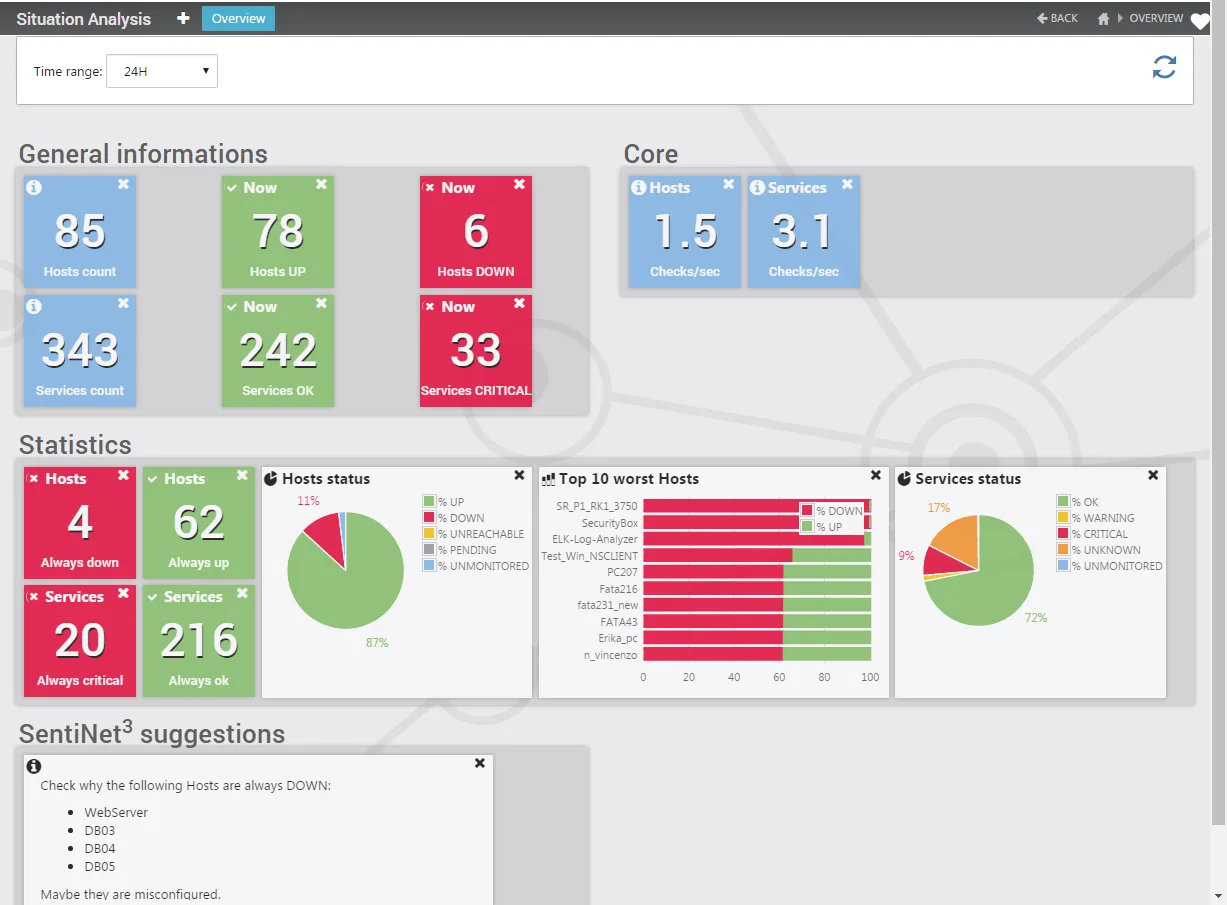
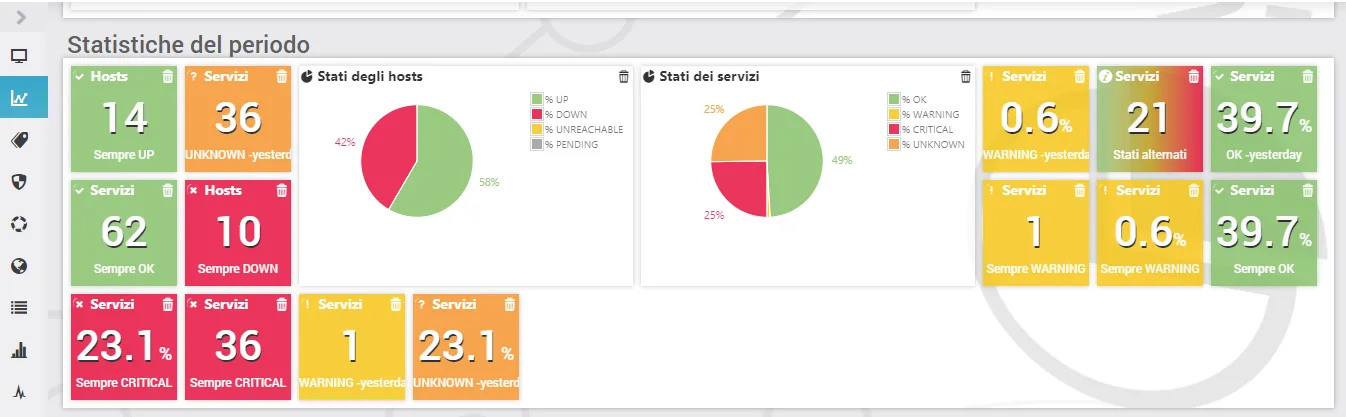
Una vista statistica dell’infrastruttura: ciò che accade ora, ciò che persiste e ciò che peggiora. Una dashboard specializzata, con widget che l’operatore seleziona, dispone e rimuove, e drill-down verso le viste operative.
- Tre prospettive: generale, per gruppi di host e servizi, storico.
- KPI su stati di host (UP, DOWN, UNREACHABLE) e servizi (OK, WARNING, CRITICAL, UNKNOWN).
- Quantità assolute, percentuali e durate.
- Top 10 dei sistemi con performance peggiori e criticità persistenti.
- Confronti con il giorno precedente e finestre di osservazione differenti.
SLA e report
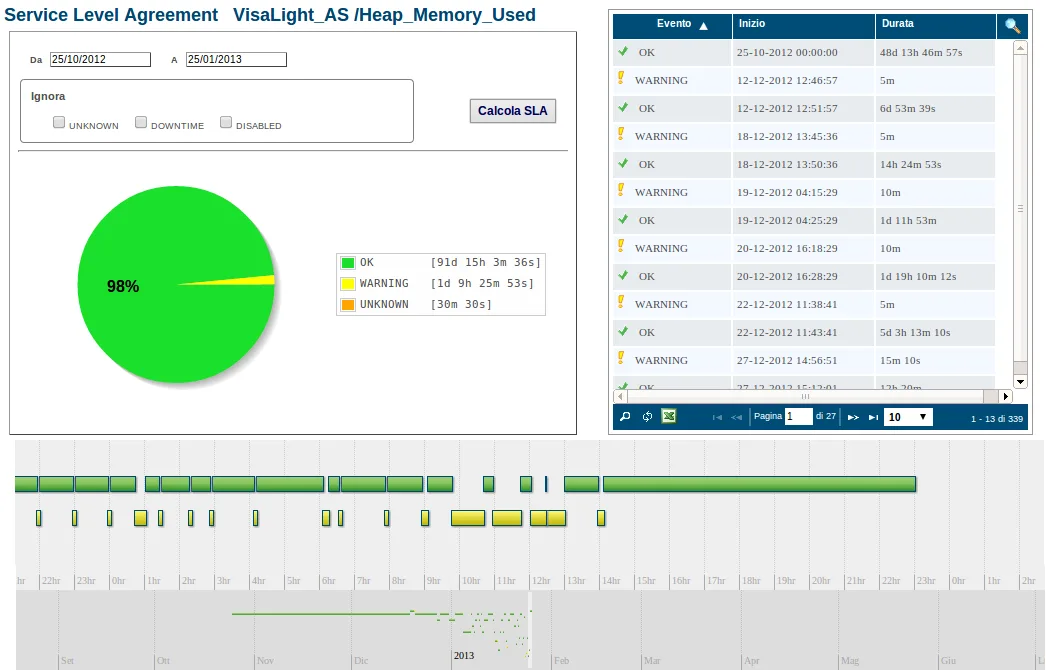
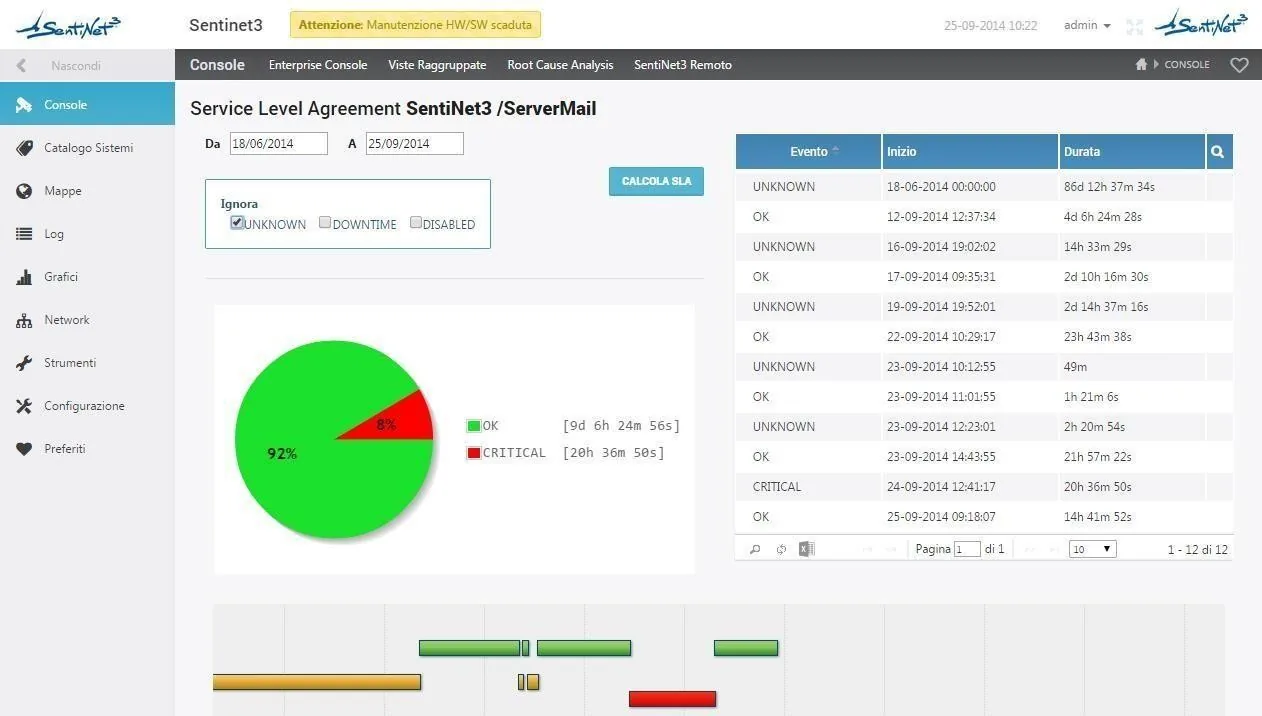
Misurare la continuità dei servizi e rendere verificabili i tempi di esercizio e di disservizio. Per ogni controllo il Core calcola la distribuzione percentuale degli stati nel periodo selezionato.
- Percentuali collegate a una cronologia verificabile: ogni cambio di stato con data, ora e durata.
- Dal risultato aggregato agli intervalli in cui si è verificato il disservizio.
- Finestre di manutenzione pianificate gestite senza alterare le misure di disponibilità.
- Grafici temporali, tabelle dei cambi di stato ed esportazione dei dati.
Allarmi, escalation e automazione
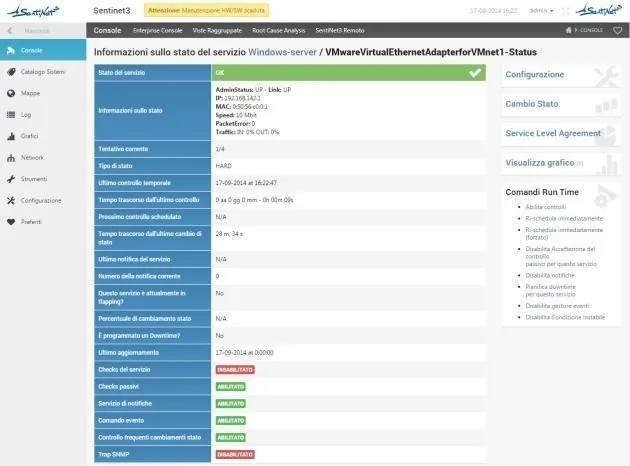
Gli eventi diventano comunicazioni tempestive, responsabilità definite e possibili azioni correttive. Quando una metrica supera una soglia o un servizio cambia stato, il Core notifica i responsabili con il contesto tecnico utile alla diagnosi.
- Notifiche via e-mail, SMS e voce; per gli scenari ambientali anche trap SNMP, post HTTP e dispositivi mobili.
- Gruppi di reperibilità e gerarchie con escalation al livello successivo.
- Antiflooding: limite di notifiche per evento e invio aggregato degli eccedenti.
- Comandi e sequenze preconfigurate al verificarsi di determinate condizioni.
- Tracciabilità di cambi di stato, notifiche, trap, accessi e log di sistema.
Funzionalità chiave
Notifiche mirate
- E-mail, SMS e voce.
- Trap SNMP, post HTTP e notifiche verso dispositivi mobili per gli scenari ambientali.
- Canale scelto in base al tipo di evento e alla configurazione.
Escalation e reperibilità
- Contatti organizzati in gruppi e gerarchie.
- Se la criticità persiste, la segnalazione passa al livello successivo.
- Nessuna dipendenza da un unico operatore.
Antiflooding
- Numero massimo di notifiche per evento in una finestra temporale.
- Eventi eccedenti accodati e trasmessi in modo aggregato.
- Contenuto informativo preservato durante i guasti estesi.
Automazione proattiva
- Riavvio di un servizio o esecuzione di uno script di manutenzione.
- Attivazione di un dispositivo di mitigazione.
- Azioni autorizzate e progettate su reversibilità e dipendenze.
Discovery e topologia
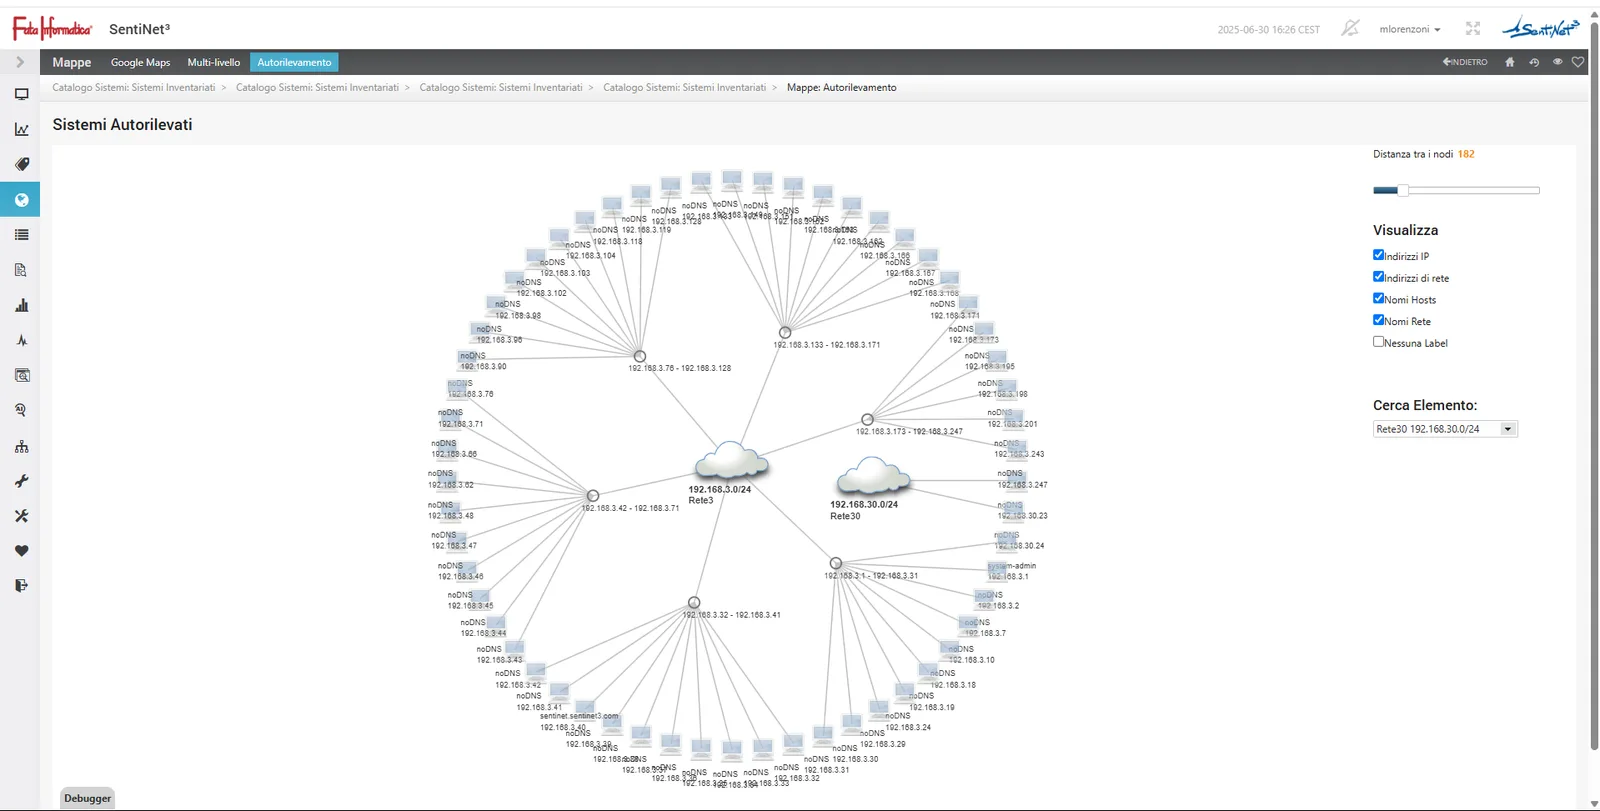
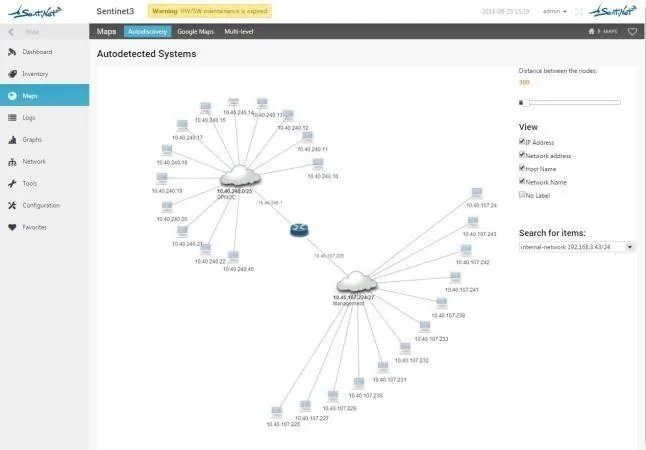
Scoprire automaticamente host, servizi e relazioni, e mantenere aggiornata la conoscenza dell’infrastruttura. L’autodiscovery identifica gli elementi da gestire, la topologia ne mostra collocazione e dipendenze.
- Scansioni a livello 2 (MAC, LLDP, trap SNMP) e a livello 3 (IP, SSH, SNMP), in modalità normale, rapida o accurata.
- Individua i “device fantasma” o non censiti, aggiorna l’inventario e notifica ogni risorsa nuova o inattesa.
- Ricerche pianificate per intercettare le modifiche successive.
- Controlli applicati attraverso pattern e template.
- Asset e connessioni ricostruiti con SNMP, LLDP e CDP: apparati, segmenti, VLAN e dipendenze.
Multisede e federazione
Monitorare sedi, data center e sistemi remoti mantenendo una visione coordinata dell’insieme, senza perdere il dettaglio necessario all’intervento sul singolo sistema.
- Gruppi di host, mappe e ruoli che riflettono la struttura territoriale e tecnica.
- Dalla vista geografica d’insieme alla singola sede, al rack e al servizio.
- Lettura federata di domini che appartengono a sedi o perimetri di gestione diversi.
- Appliance fisiche o virtuali distribuite in base a volumi, topologia e requisiti di esercizio.
Sicurezza nativa: progettata per contesti ad elevato livello di sicurezza
Sentinet³ è progettato per lavorare in contesti ad elevato livello di sicurezza, anche classificati. Il Core integra misure di autoprotezione che limitano l’esposizione del sistema di monitoraggio e governano l’accesso alle informazioni raccolte, perché lo strumento di osservazione non diventi esso stesso un punto di esposizione.
Approfondisci- Accesso: autenticazione a due fattori (2FA) e meccanismo anti brute force.
- Applicazioni web: Web Application Firewall (WAF) interno.
- Perimetro di rete: firewall integrato.
- Dati e segreti: protezione avanzata delle credenziali e file system criptato.
- Configurazioni: protezione avanzata dei file di configurazione e hardening contro privilege escalation.
- Isolamento: isolamento avanzato delle applicazioni.
Architettura e tecnologia
Sottosistemi di visualizzazione, correlazione, apprendimento e notifica lavorano su un database in memoria e su un database di configurazione, alimentati da un gestore che raccoglie i dati con agent e in modalità agentless.
- Portale web responsive
- In-memory processing
- Integrabile con sistemi di terze parti
- Integrato con QR code
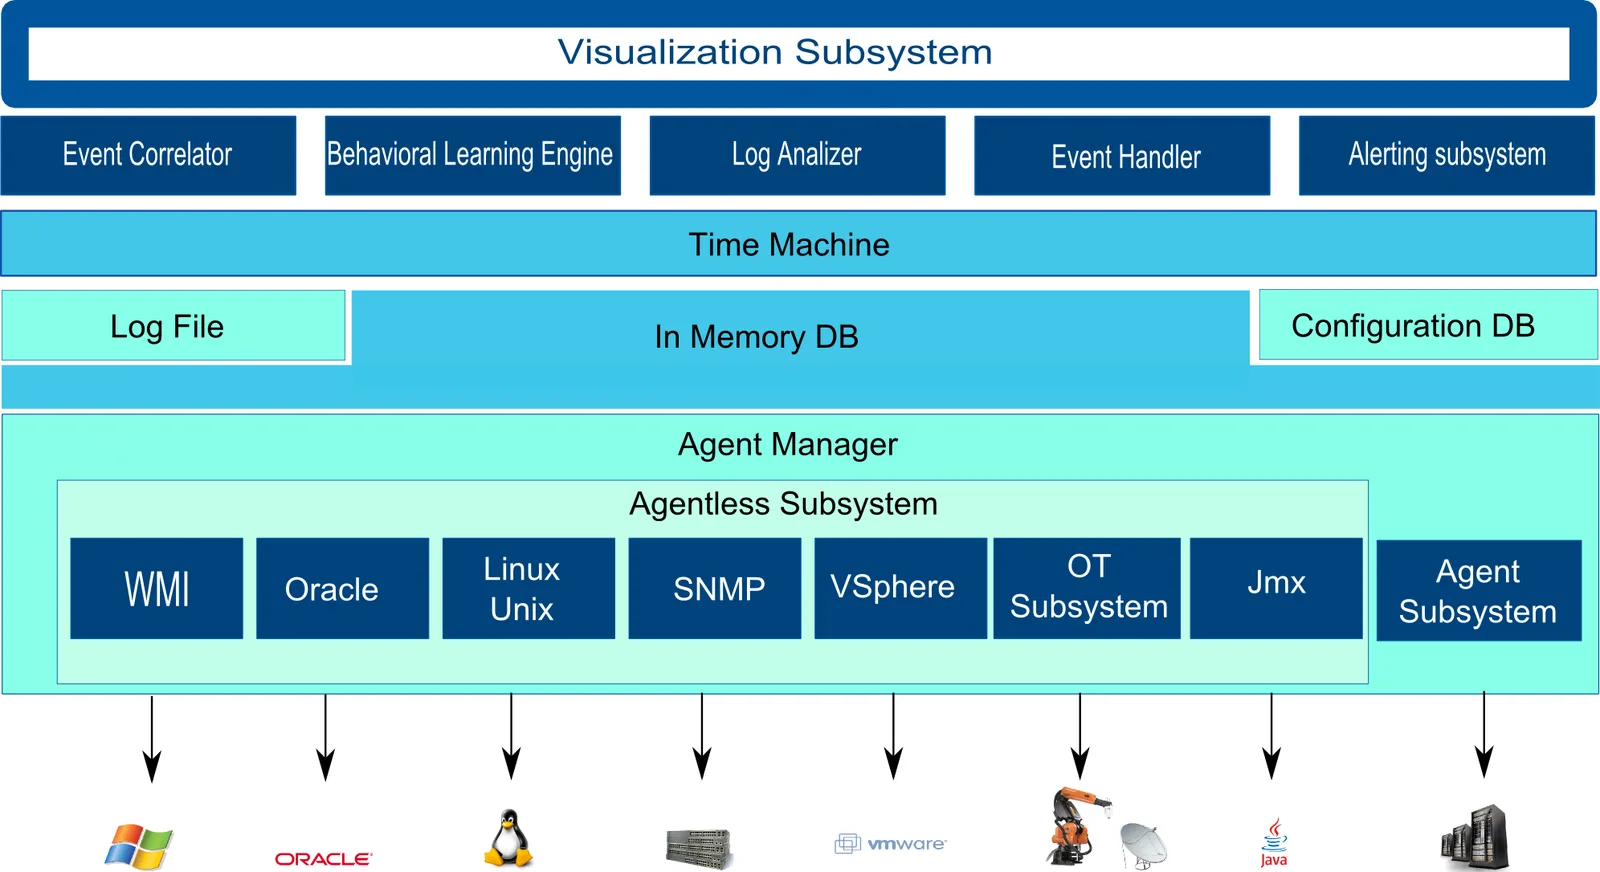
Interoperabilità con sistemi eterogenei
Protocolli standard, agent, script e plug-in portano tecnologie diverse nella stessa console e nello stesso modello di stato. Pattern e template riutilizzabili accelerano la configurazione dei controlli.
Tutte le compatibilità- Windows
- Linux
- Unix
- HP-UX
- Solaris
- AIX
- AS/400
- VMware ESX
- Hyper-V
- Xen
- KVM
- Oracle
- SQL Server
- MySQL
- DB2
- PostgreSQL
- Tomcat
- WebSphere
- WebLogic
- JBoss
- Exchange
- SharePoint
- IIS
- Active Directory
- SNMP e trap
- WMI
- SSH
- NRPE e plug-in
- HTTP
- SMTP
- TCP / UDP
- Syslog
La base comune di Sentinet³ Infinity
Il Core è la base su cui si innestano i moduli specializzati della linea Infinity: Network Insight, Application Insight, Security Insight, Threat Insight e AI Insight riutilizzano lo stesso contesto operativo e condividono la stessa console. L’adozione può essere progressiva.
Scopri Sentinet³ InfinityIl Core al lavoro
Saturazione progressiva di un servizio, guasto di connettività multisede, temperatura anomala in sala apparati, anomalia notturna, nuovo servizio da mettere sotto controllo: situazioni tipiche che mostrano come il Core migliori prevenzione, diagnosi e ripristino.
Vai agli scenariVuoi vedere Sentinet³ sulla tua infrastruttura?
Raccontaci il tuo contesto: sedi, tecnologie, servizi critici. Ti mostriamo come Core e Infinity possono lavorare sul tuo caso.